O Publica — Apoio a Revistas e Publicações Científicas é uma plataforma do LabP² para as equipes editoriais de revistas científicas. O primeiro módulo transforma o manuscrito em PDF no XML JATS exigido pelo SciELO, com a lista do que conferir antes da submissão. A marcação é sugerida por inteligência artificial e conferida pelo editor.
Para publicar no SciELO e em outros indexadores, cada artigo precisa ser entregue em XML JATS, uma marcação detalhada de título, autores, afiliações, resumos, seções e referências. Feita à mão, essa marcação é lenta, cara e sujeita a erro, e costuma ser terceirizada por revistas com equipes pequenas. O Publica lê o PDF, propõe a marcação e deixa o editor conferir e corrigir antes de gerar o XML.
Inteligência artificial a serviço do editor
O Publica usa inteligência artificial em uma tarefa bem delimitada: dizer o que é cada trecho do artigo (título, autores, resumo, seção, referência). Quem faz isso é um classificador de machine learning (aprendizado de máquina), treinado pelo próprio LabP². Em vez de alguém escrever regras para cada revista, o classificador aprendeu com exemplos. Ele sugere, e o editor confirma ou corrige cada marcação.
Como o modelo foi desenvolvido
- Exemplos que já existiam: o classificador aprendeu com milhares de artigos já publicados em acesso aberto, para os quais há o PDF e o XML oficial. O XML oficial serve de gabarito: mostra qual é o papel de cada trecho do PDF, sem que ninguém precise rotular à mão.
- Dois modelos em conjunto: um modelo de linguagem, ajustado pelo Laboratório, lê o texto de cada trecho e dá o seu parecer; um classificador leve junta esse parecer ao que se vê na página (posição, tamanho da letra, vizinhança) e decide a sugestão.
- Teste com revistas nunca vistas: as revistas foram separadas em dois grupos antes do treino. O modelo é ajustado com um grupo e medido, uma única vez, com o outro. O resultado, assim, indica o que esperar de uma revista nova.
- Modelos pequenos, em servidor comum: o objetivo desde o início foi um modelo que rodasse sem placa de vídeo, na infraestrutura da própria instituição. O artigo é processado ali, sem depender de serviços comerciais de inteligência artificial.
- O que o editor ensina fica com o editor: as regras criadas por cada revista valem por cima da sugestão do modelo e nunca entram no treino nem na avaliação.
- Modelos abertos: os modelos treinados estão publicados no perfil do LabP² no Hugging Face, para que outras equipes possam reusar e conferir.
Destilação de modelos
Destilação é passar o conhecimento de um modelo grande, caro e lento para um modelo pequeno, barato e rápido: o grande faz o papel de professor e o pequeno, o de aluno. É a linha de trabalho do LabP² com inteligência artificial, porque o modelo final precisa caber no servidor de uma instituição pública. No Publica, o gabarito veio dos XML oficiais, e o modelo de linguagem empresta ao classificador leve a sua leitura do texto. No Ulysses, em que não há gabarito pronto, são modelos de linguagem que rotulam os exemplos com que o classificador aprende.
O que o sistema faz
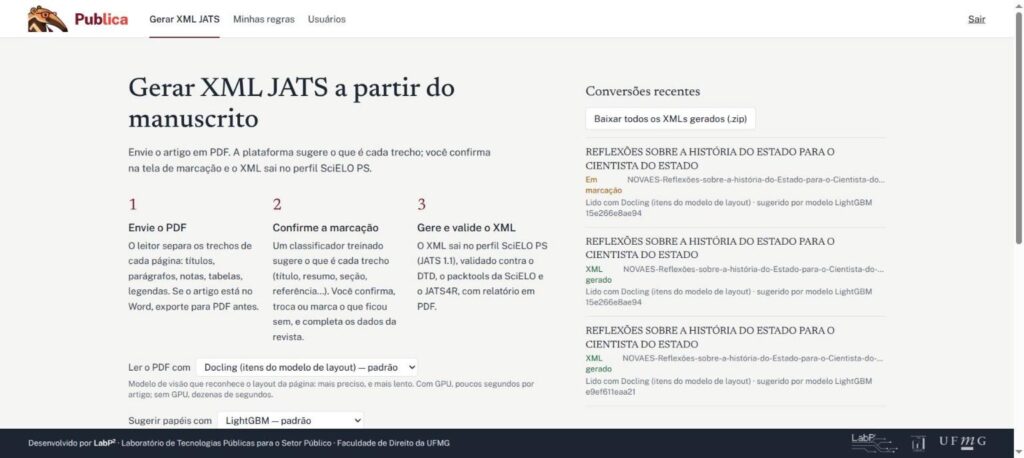
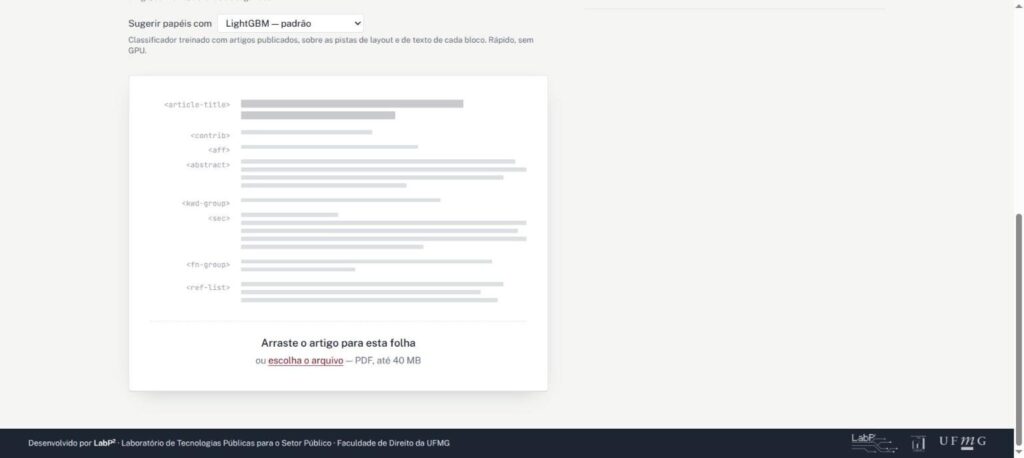
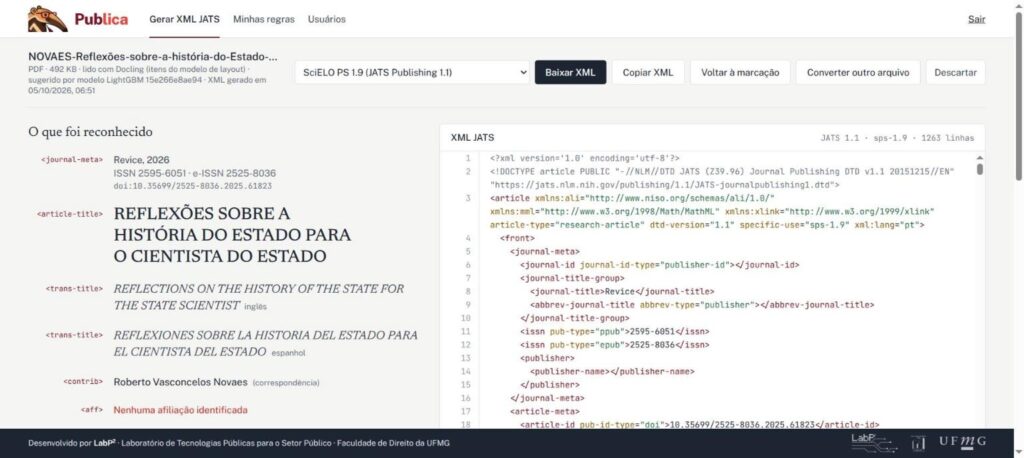
- Leitura do PDF: o editor envia o artigo em PDF e o sistema o divide em blocos, na ordem da página, com um leitor de layout (Docling) ou com um leitor mais leve, que dispensa placa de vídeo (pdfminer).
- Sugestão da marcação: um classificador treinado em milhares de artigos já publicados propõe o papel de cada bloco (título, autores, resumo, seção, referência…).
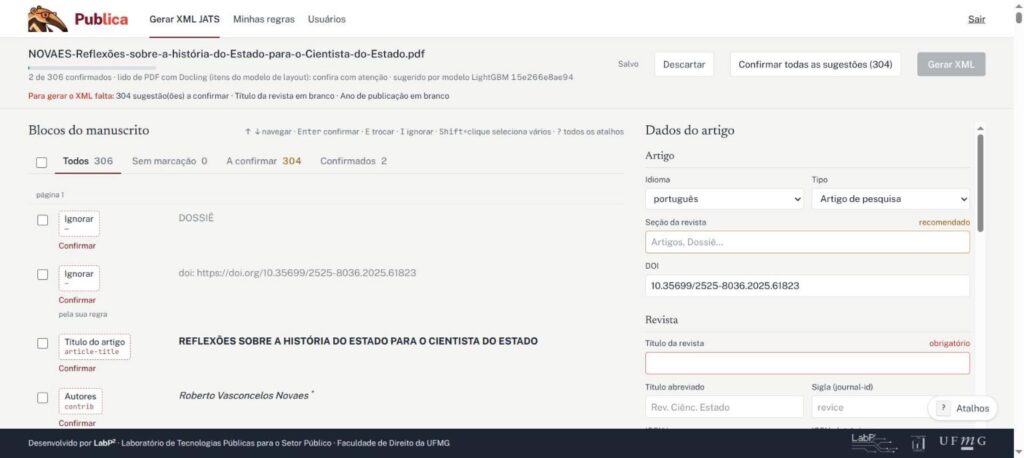
- Tela de marcação: o editor confirma ou troca cada papel, junta e divide blocos e monta tabelas; nada vai para o XML sem a confirmação dele. Atalhos de teclado agilizam a conferência.
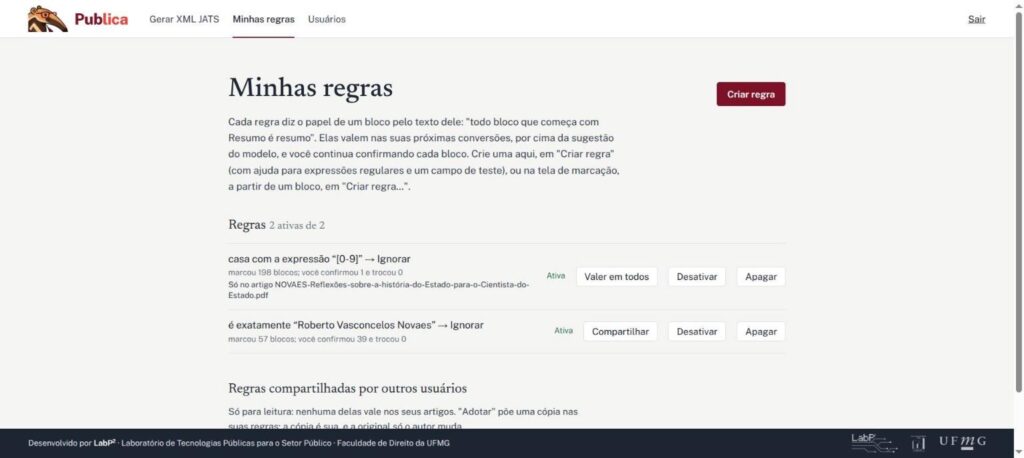
- Regras do editor: convenções da revista (o cabeçalho que se repete, o rótulo “Palavras-chave:”, a linha do autor com ORCID) viram regras criadas uma vez e aplicadas nos artigos seguintes, sempre à espera da confirmação. O sistema mostra quanto cada regra acerta.
- Validação: o XML gerado é conferido no esquema JATS 1.1, no validador do SciELO (packtools) e nas recomendações JATS4R, com um relatório em PDF para enviar ao autor ou arquivar.
- Outros formatos: além do SciELO PS, o XML pode ser baixado no formato da Redalyc (Marcalyc) e no JATS padrão, nas versões 1.1 a 1.4.
Telas do sistema
As capturas acompanham a conversão de um artigo, do envio do PDF ao XML. Clique em uma imagem para ampliá-la.
Nada é inventado
O que o manuscrito não traz fica vazio no XML e vira aviso na revisão. O sistema não preenche dados por conta própria: o editor completa o que falta (ISSN, DOI, volume, número) e decide cada marcação.
Pesquisa
O Publica é também objeto de pesquisa do LabP². O classificador foi treinado e avaliado com 3.527 artigos de seis coleções (SciELO, PMC, PLOS e Redalyc), predominantemente em português, espanhol e inglês, e testado em 664 artigos de 112 revistas que ficaram fora do treino. Nesse teste, ele acertou o papel de 94,9% dos blocos. Os resultados estão sendo preparados para publicação.
Princípios de desenvolvimento
- O editor decide: a automação sugere, e a palavra final é sempre de quem conhece a revista;
- padrões abertos: JATS, SciELO PS e as recomendações JATS4R;
- roda em servidor comum, sem placa de vídeo, na infraestrutura da própria instituição;
- reaproveitamento por outras revistas e instituições públicas.
Como usar
O Publica está em uso em publica.direito.ufmg.br. O acesso é feito por conta criada pelo Laboratório; revistas interessadas podem entrar em contato pelo formulário de contato.
Saiba mais sobre a atuação do Laboratório na página Nosso Projeto.